在 CMIS 2026,我发现医药企业 AI 的下一关不是模型,而是责任!
2026-08-31
医药企业 AI 的下一关,不是接入更大的模型,而是让知识、权限、流程和责任连成一条可验证的链。
海晶准生物医药有限公司 李翔
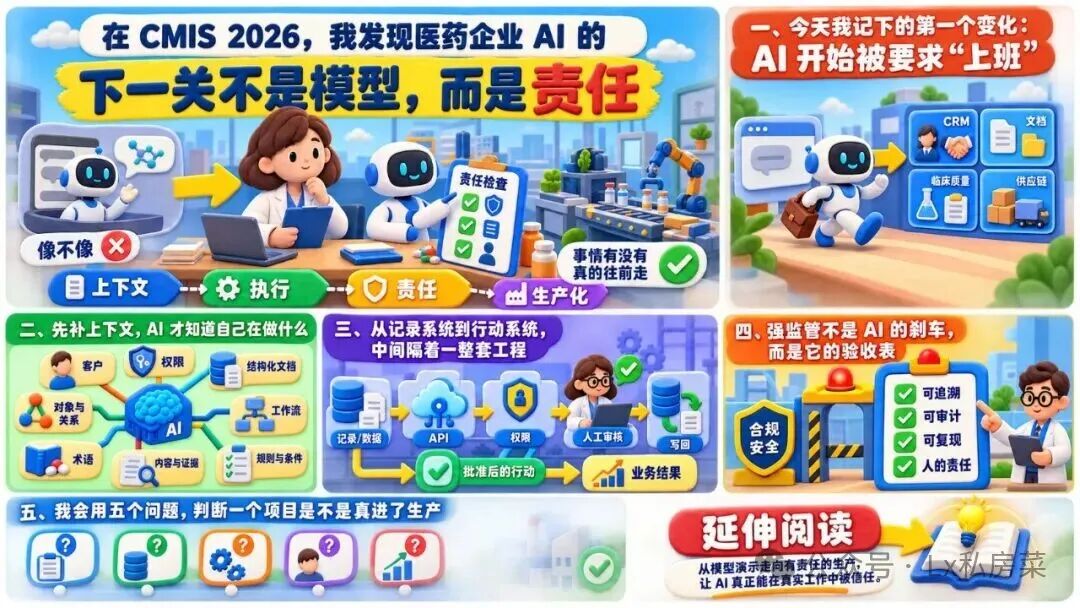
我今天在上海参加了 CMIS 2026 第八届中国医药数智峰会。散场时,我脑子里留下的不是“哪家厂商有几个 Agent”,而是一个更具体的问题:药企到底愿不愿意把一部分真实工作交给 AI?
这和“愿不愿意试用一个聊天机器人”不是一回事。前者意味着 AI 要接触企业知识、业务系统和权限,还要在结果不对时留下证据、接受追问,并有人承担最后的责任。
说明:今天有些演讲因为录音设备问题,没有取得完整的内容转录。为避免断章取义,文中不体现这部分内容,只记录我能够确认的分享和现场观察。
今天我记下的第一个变化:AI 开始被要求“上班”
过去谈企业 AI,现场很容易围绕模型、参数和 Demo 展开。今天的议程却明显换了重心:客户互动、文档翻译、本体、CRM、临床质量、Agent 集群、供应链,几乎都在追问同一件事——AI 能不能进入已有的工作,而不是在工作旁边再开一个窗口。
这也是我理解“数智破局 · 全链提速”的方式。所谓“全链”,不是把每个部门都贴上 AI 标签,而是让一个判断能够从资料和规则出发,经过权限控制,进入业务流程,再把结果回写回来。
我在现场反复用一个标准筛选这些分享:它有没有越过“回答得像不像”,进入“事情有没有真的往前走”。按这个标准看,今天最有价值的内容,恰恰不是最会展示模型的内容,而是那些把上下文、接口、审阅和业务指标讲清楚的内容。
先补上下文,AI 才知道自己在做什么
我以前也容易把企业知识库理解成“把 PDF 丢进向量库”。今天几场分享让我重新意识到,这个理解太薄了。
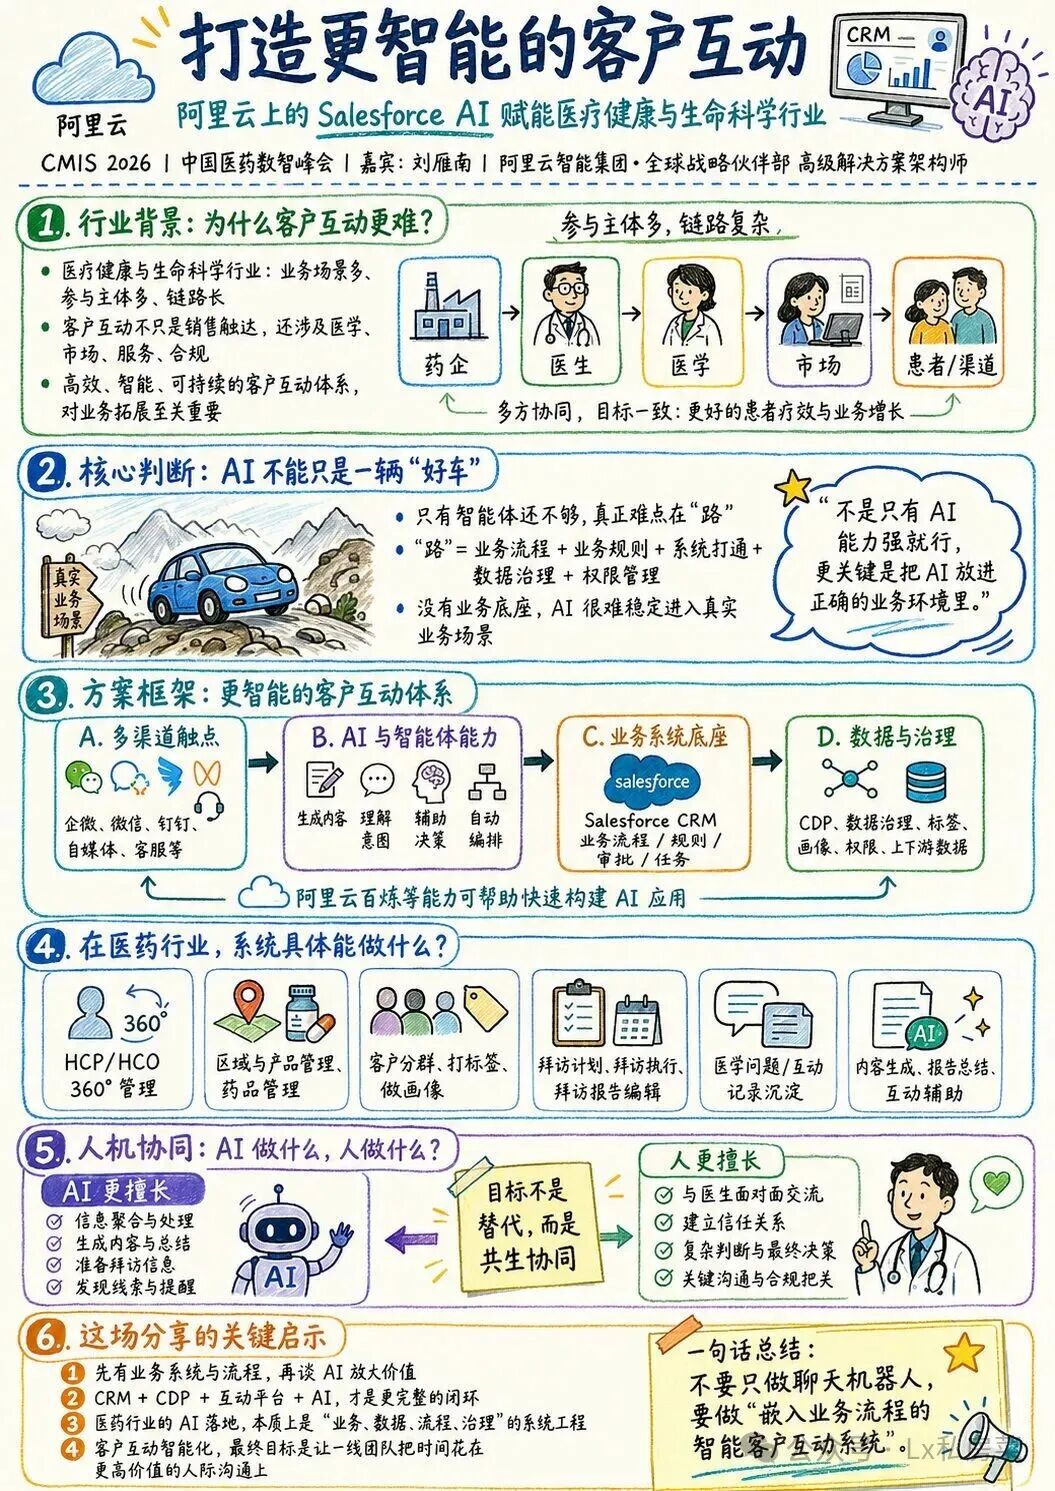
阿里云和 Salesforce 的分享从客户互动切入:医疗健康场景里的 AI 要知道客户是谁、组织处于什么关系、历史上发生过什么,还要知道当前员工有没有权限看见和执行下一步。没有 CRM、CDP 和业务语义,模型得到的只是脱离现场的提问。
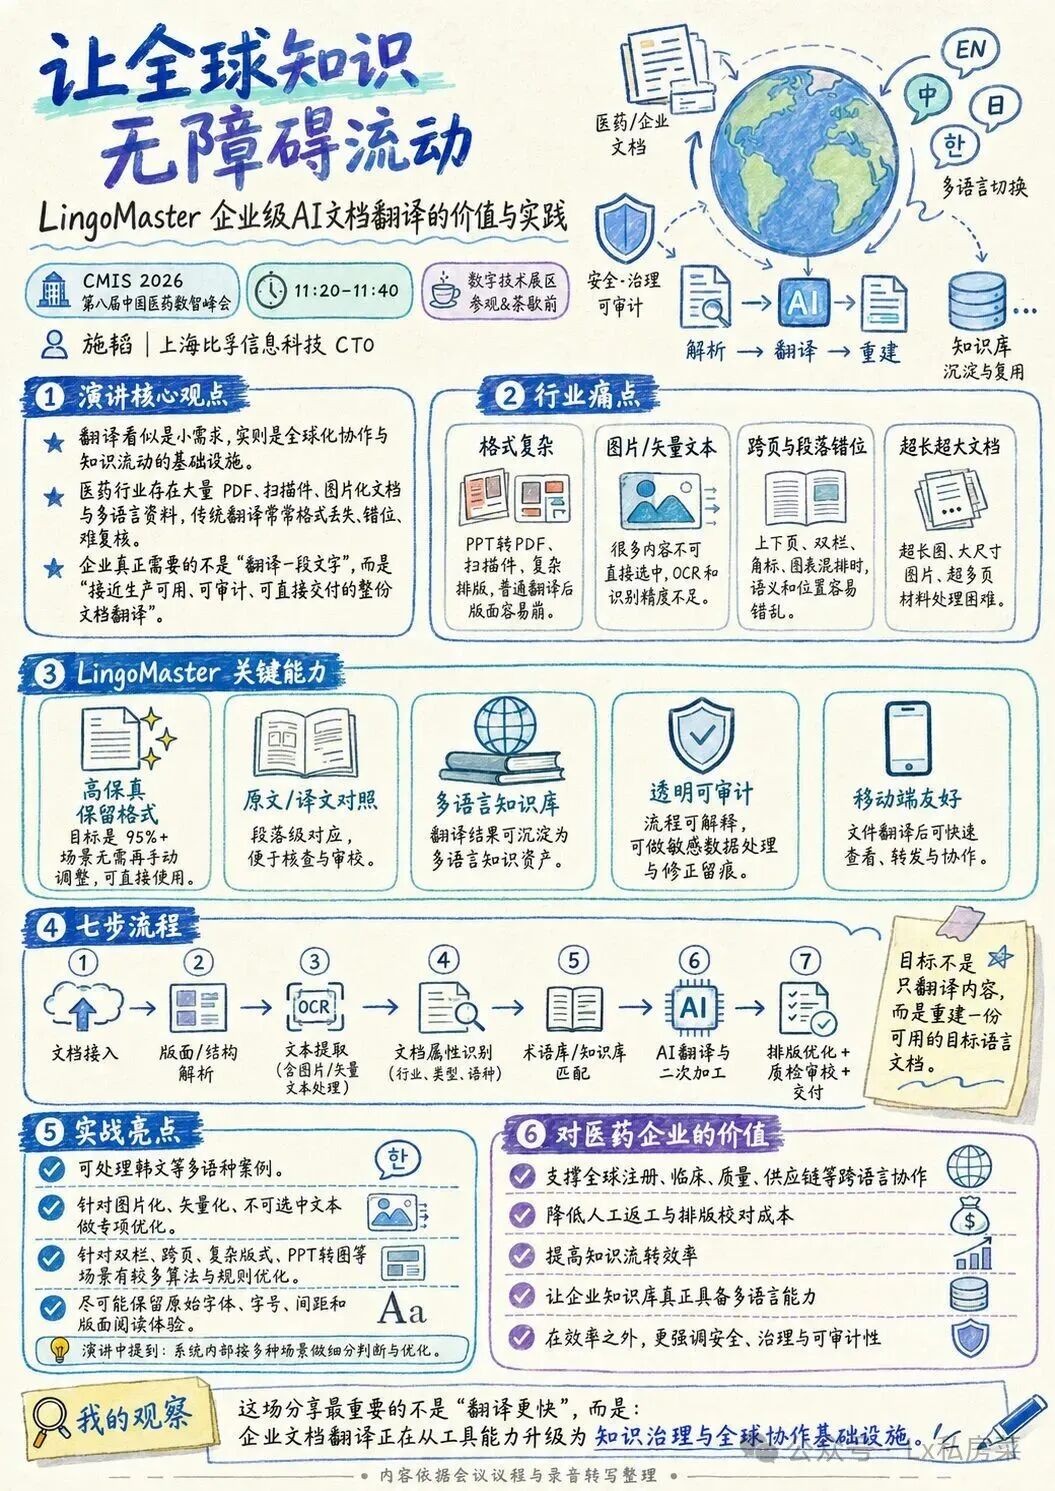
LingoMaster 的信息图则把“文档”本身拆开了:结构、版式、多语言、术语、隐私、审计和人工纠正,都是企业文档的一部分。对药企来说,一份文件不是把句子翻译通顺就结束了,格式和版本也可能关系到它能不能进入后续流程。
以岭药业讲“本体驱动企业智能引擎”,合合信息讲“文档筑基,数据可信”。这两场放在一起看,刚好补上了上下文的两个面:本体解决“企业里的对象和关系是什么”,可信文档与数据解决“我凭什么相信这条信息”。
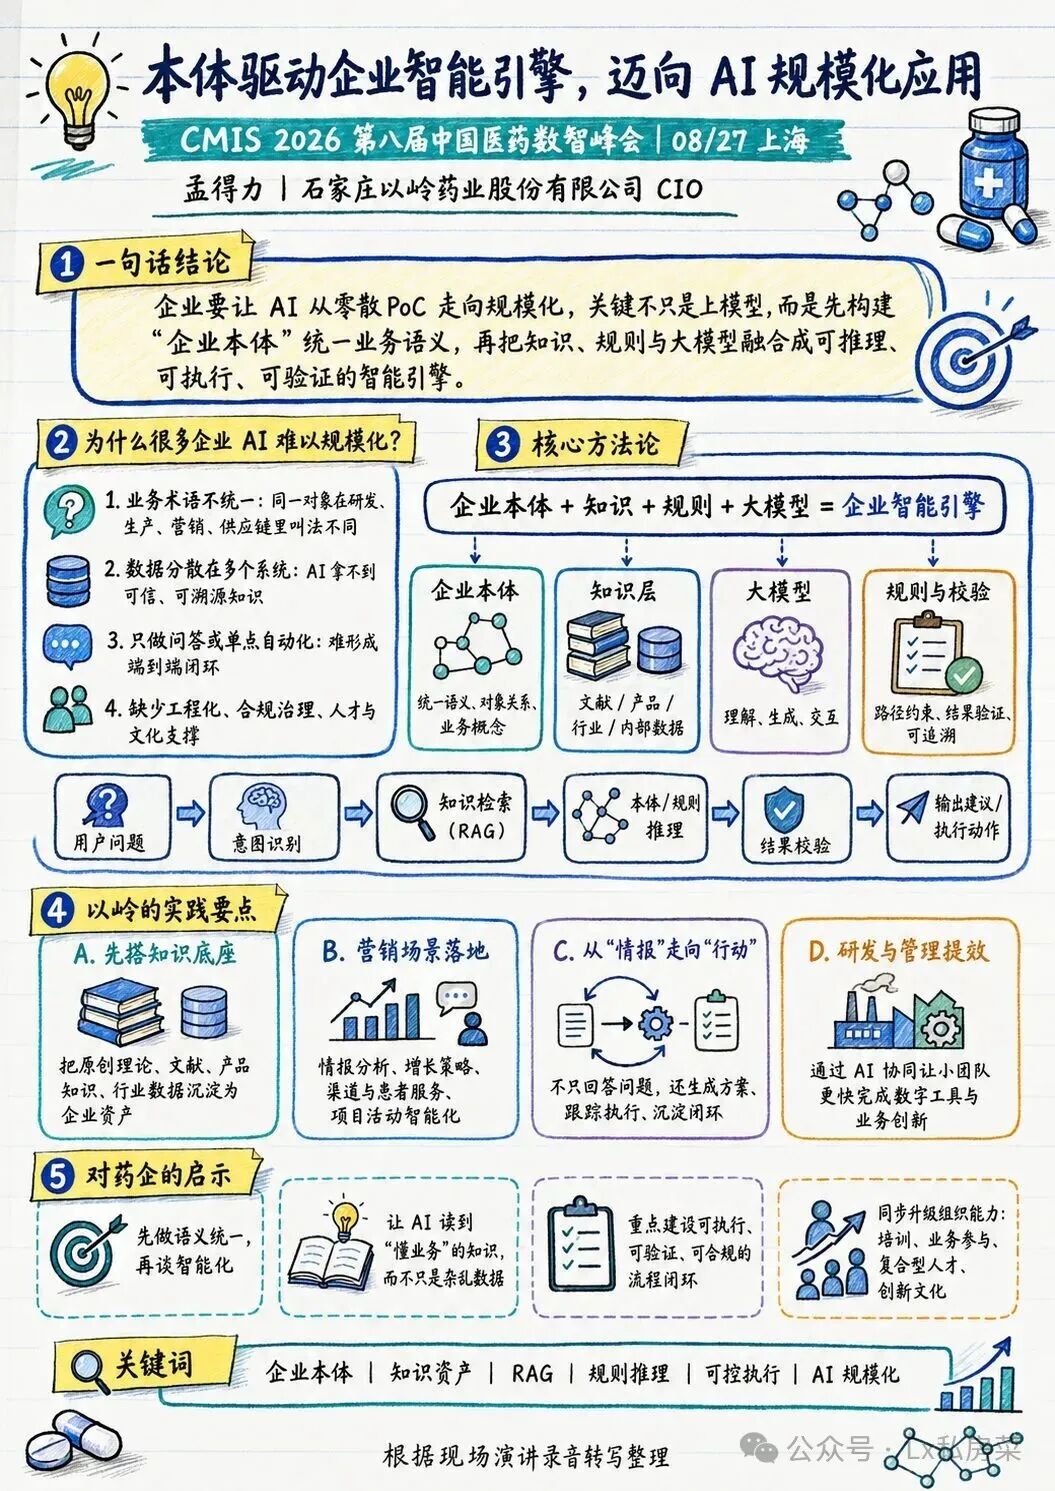
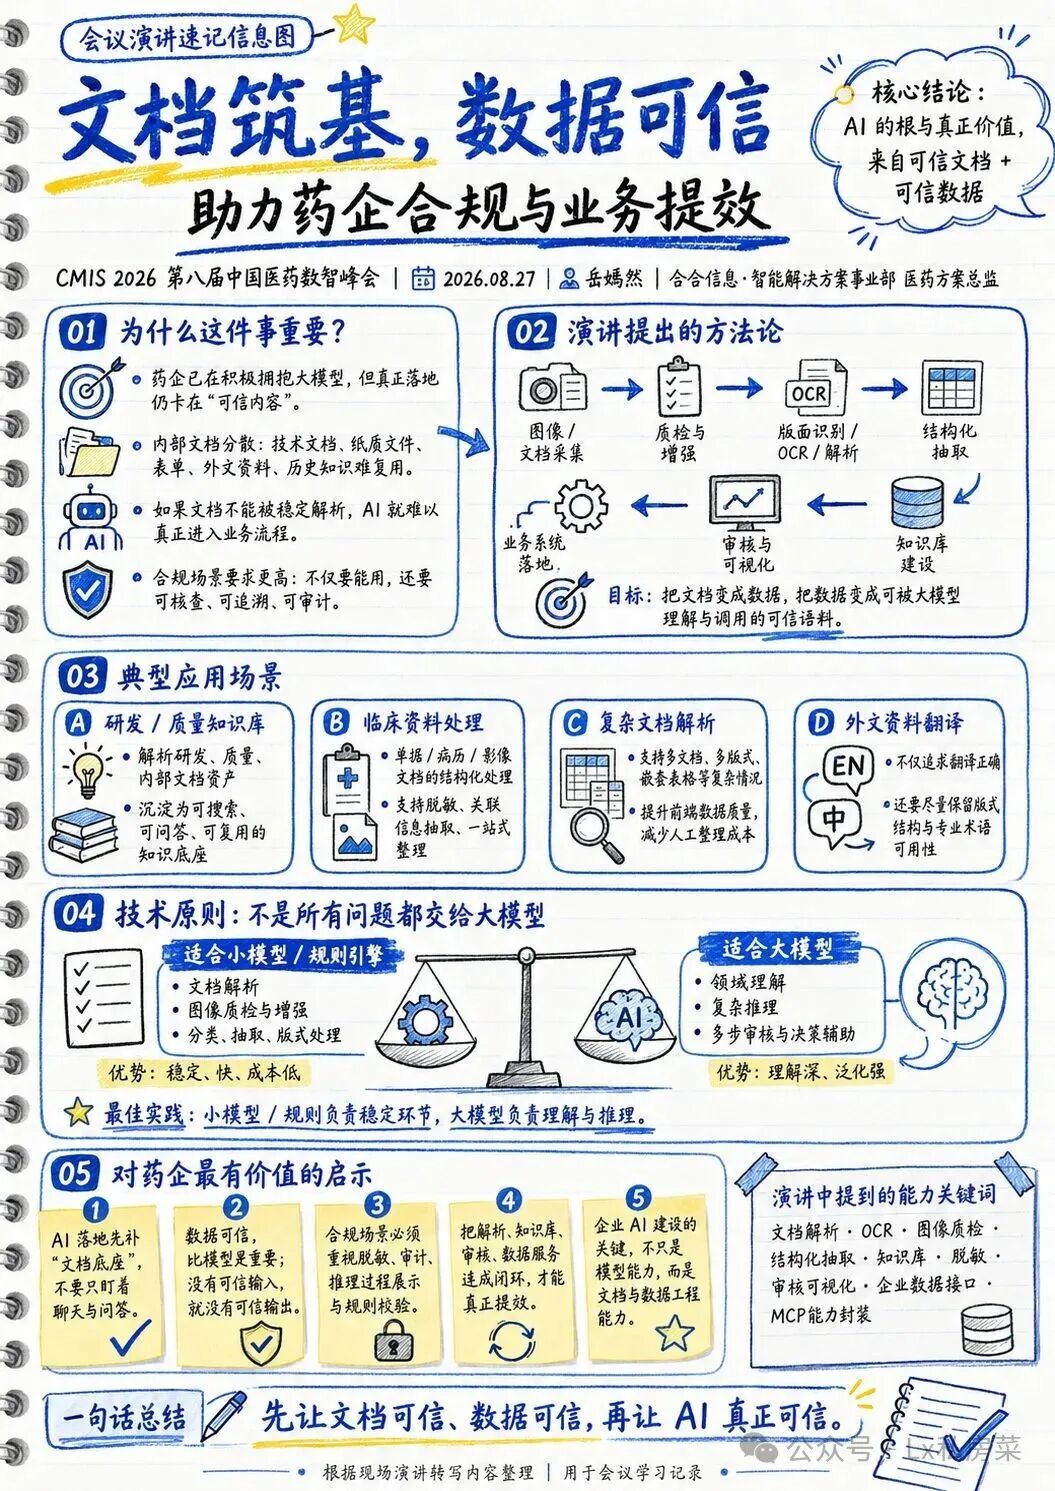
所以我现在更愿意把企业上下文写成一条链:对象与关系、内容与证据、规则与条件、流程与接口。RAG 解决的是“把可能相关的内容找出来”;企业智能还要继续回答“它和谁有什么关系”“在什么条件下成立”“下一步能不能做”。
这也是我在企业 AI 工作流重构,难点不在加一个 Agent(链接:https://ntlx.github.io/articles/enterprise-ai-workflow-redesign)一文里没有讲完的部分:工作流不是把几个模型节点串起来,而是把企业原本依赖人的判断,拆成可引用、可验证、可执行的上下文。
从记录系统到行动系统,中间隔着一整套工程
纷享销客的分享给了我一个很直观的变化:CRM 正从“记录发生过什么”,走向“帮助下一步发生什么”。这就是从 System of Record 到 System of Action 的变化。
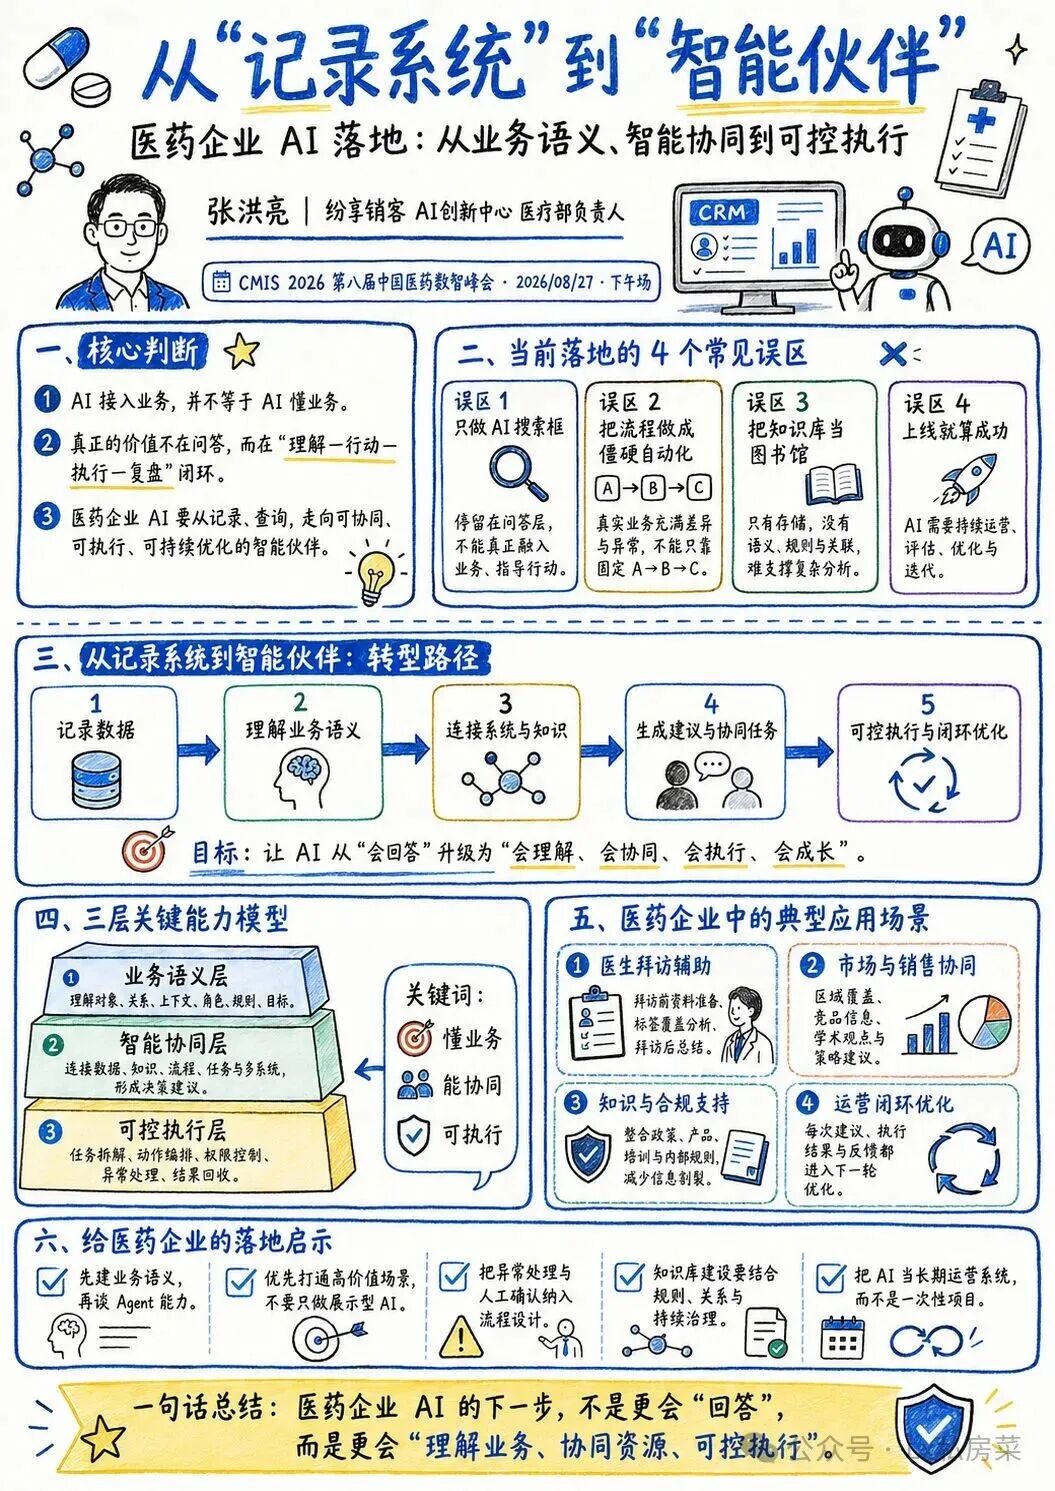
但“智能伙伴”不是换一个更有拟人感的名字就成立了。它至少要完成几步:理解目标,取得相关上下文,检查权限,调用工具,生成或执行动作,回写结果,遇到例外时把问题交给合适的人。
实在智能把遗留系统连接、权限管理、私有化部署、页面自动修复和运行维护都摆到台面上。对我来说,这比“一个 Agent 能否完成任务”的演示更接近生产现场。因为企业真正难改的,往往不是模型,而是那些没有标准 API 的旧系统、写在员工经验里的例外规则,以及出了问题没人知道的黑箱动作。
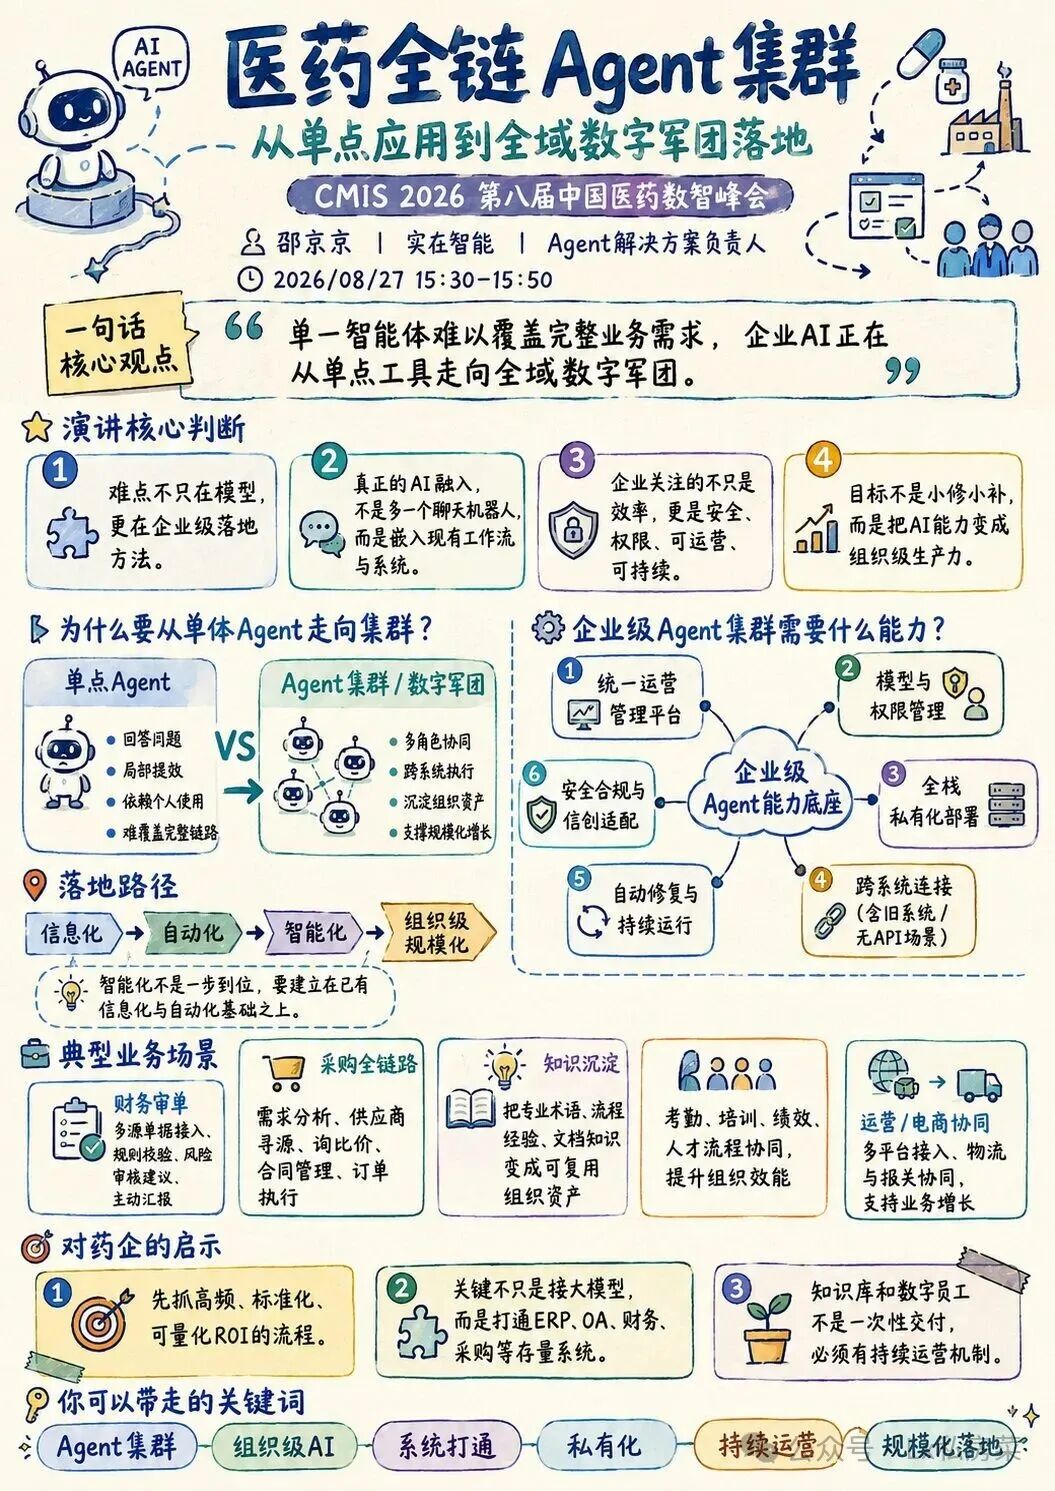
我会特别警惕一种表面上的繁荣:企业拥有越来越多 Agent,但没有统一身份、权限、日志、评估和回滚机制。Agent 数量增加,不等于执行能力增加;如果每个 Agent 都有一套没人维护的提示词和知识库,它们最后可能只是新的“数字烟囱”。
供应链场景更能检验这件事。采购、销售、物流、财务和零售运营里的 AI,不能只展示一条漂亮的推理链,而要接受库存、缺货、交付、周转和人员工作量这些业务结果的检验。
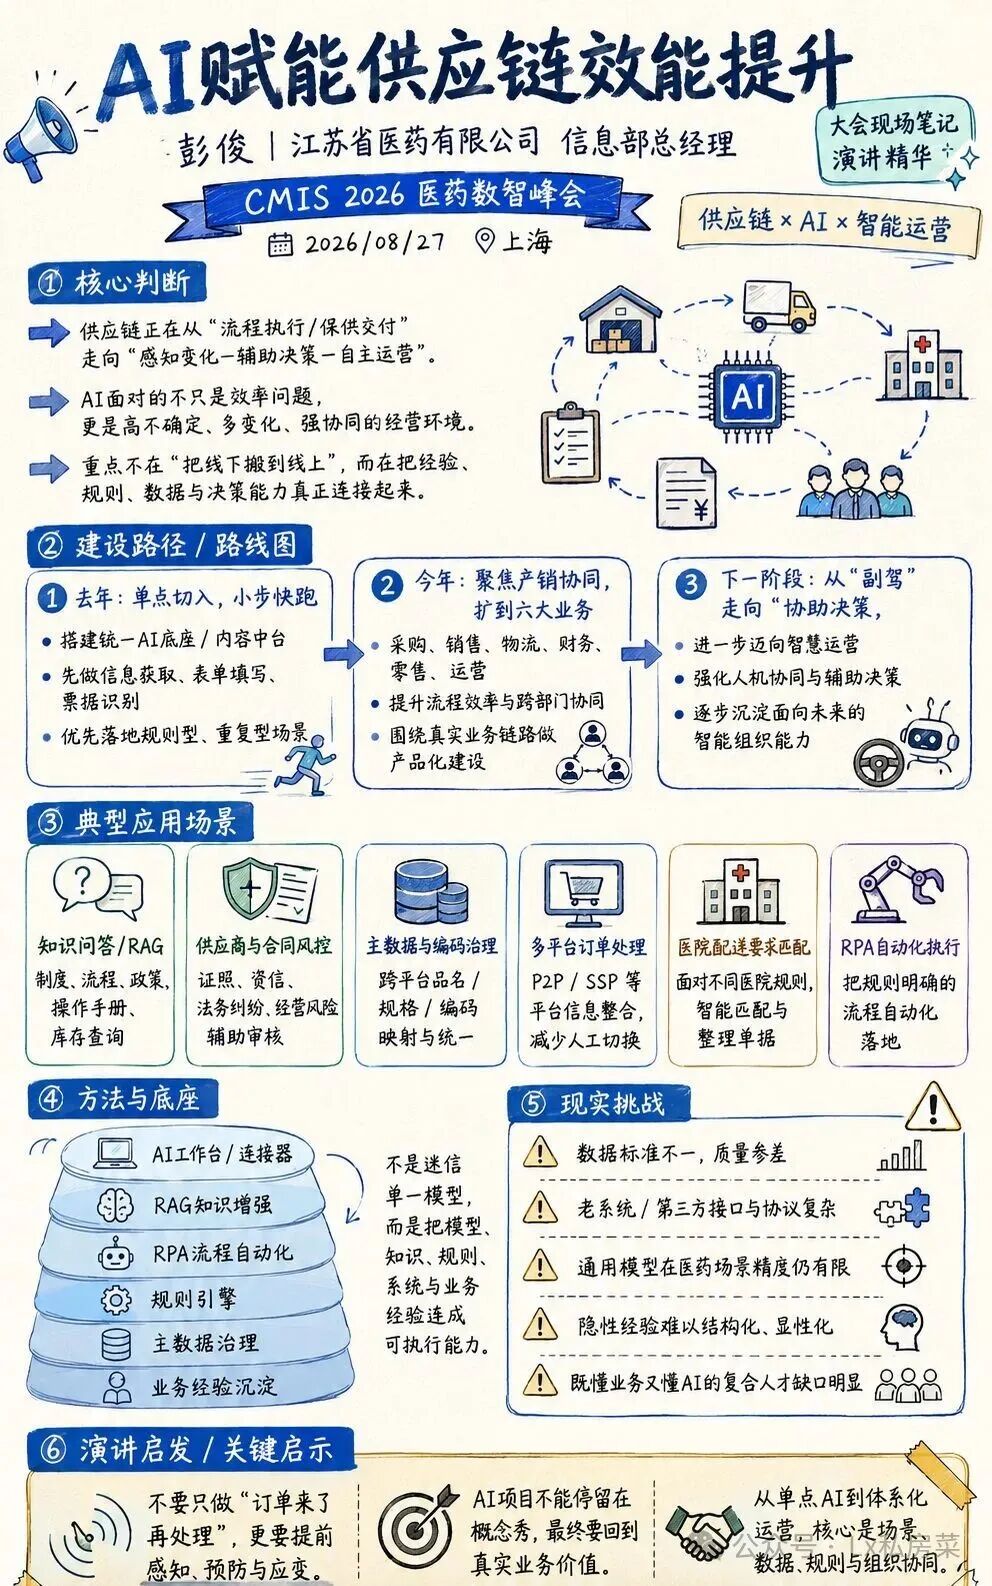
所以,Agent 的成熟度不应先用数量衡量,而应看三件事:它能不能进入真实流程,动作有没有权限和边界,结果能不能回到业务系统里被复盘。
强监管不是 AI 的刹车,而是它的验收表
药品注册申报、临床和质量,是今天让我最确定的一组场景。这里当然需要效率,但“生成得快”排在“说得清楚”之后。
复宏汉霖的注册申报分享把过程拆得很清楚:从源文档和历史材料出发,结合规则和模板生成内容,再做来源追溯、检查和人工审核。凯莱英临床(凯诺)的分享也把知识库、模块化编辑、二次校验、审阅和报告分析放在同一个工作结构里。
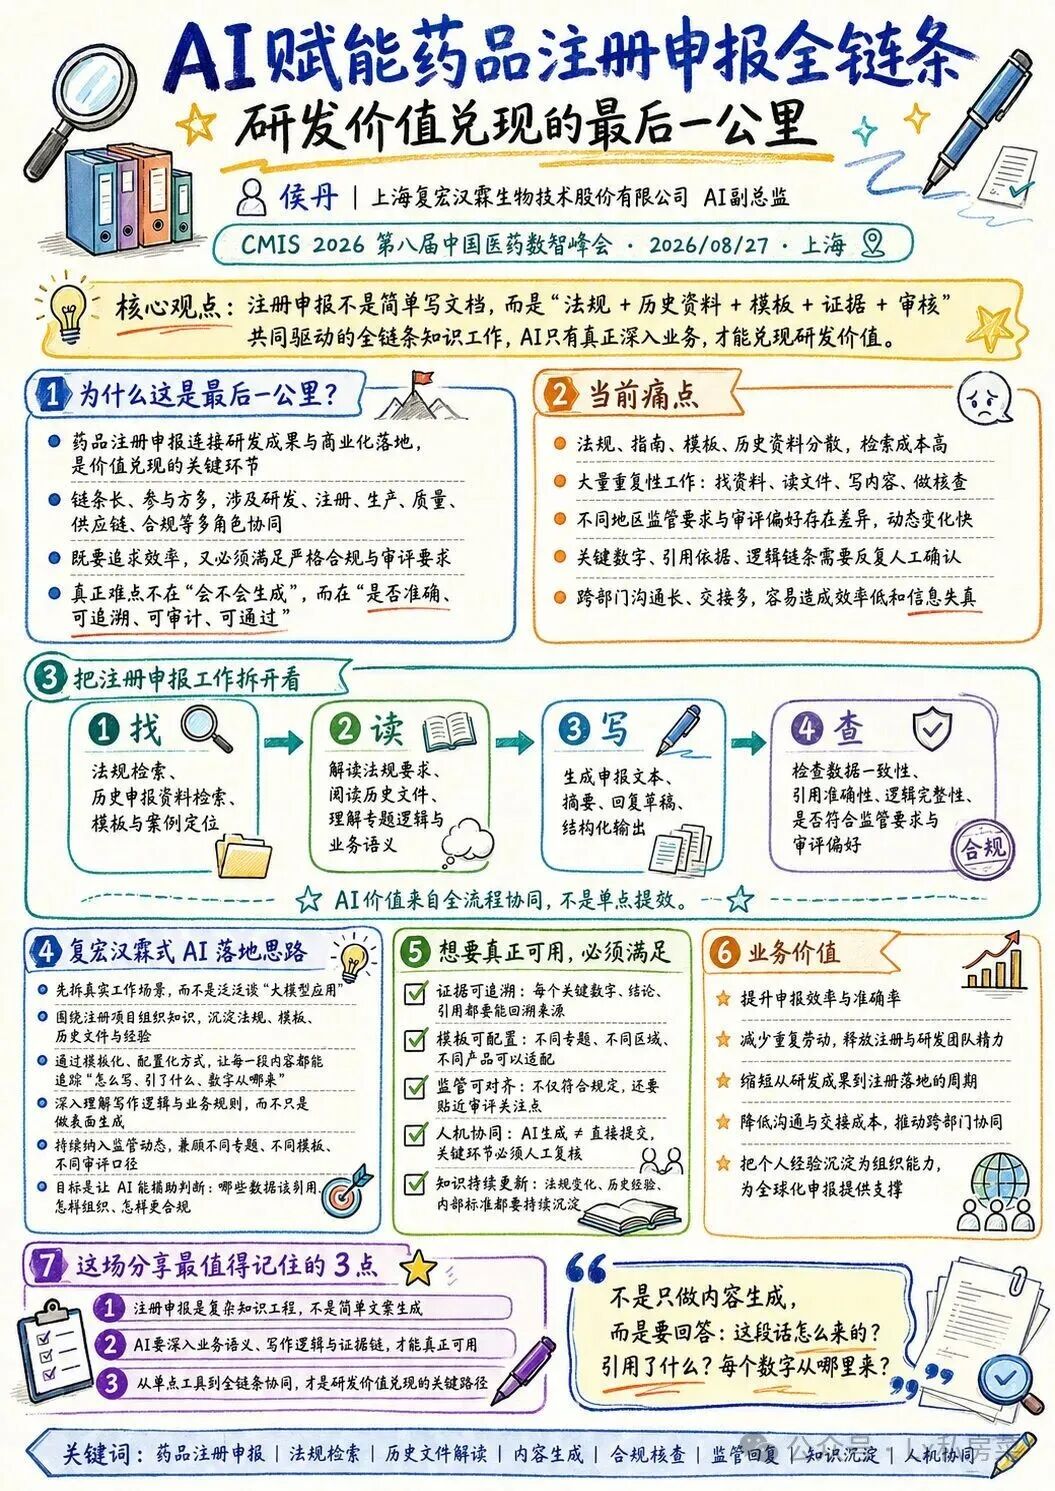
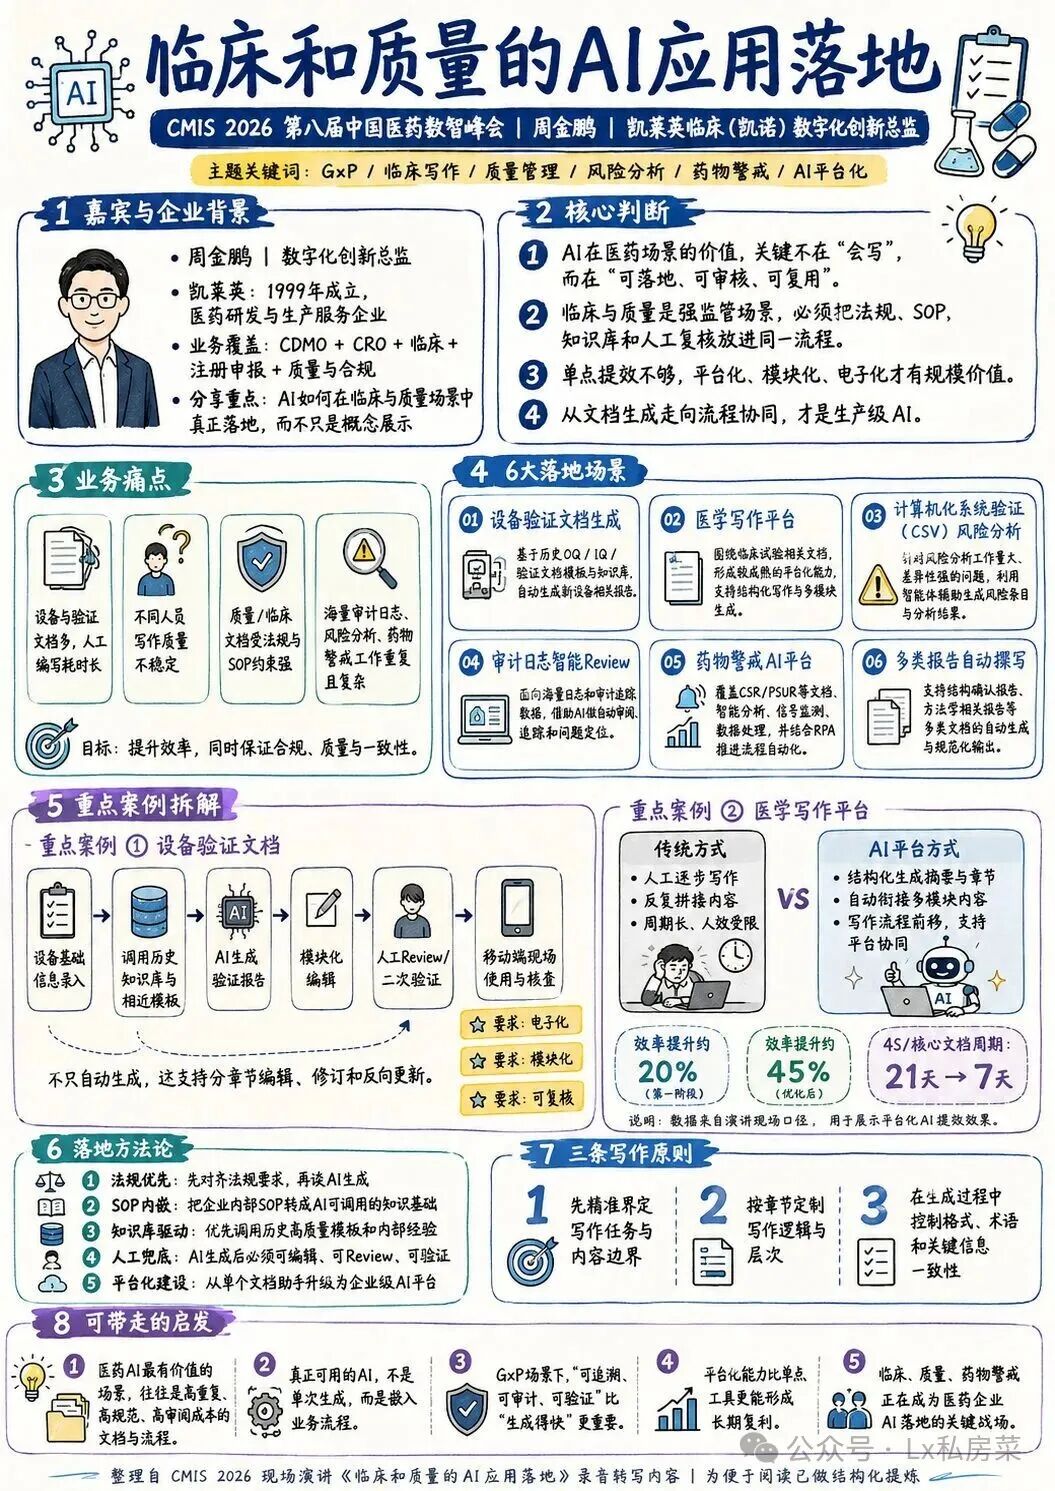
我把这个结构压缩成一条证据链:输出 → 主张 → 证据 → 来源 → 版本与时间 → 责任人。它不要求 AI 永远不犯错,但要求系统能够发现错误、限制错误、解释错误,并在必要时把决定升级给人。
这时,Human-in-the-loop 也不再只是流程末尾的一个确认按钮。不同风险等级应该对应不同的查看、修改、执行和签署权限。人不是为了替机器重新做一遍,而是要在系统里拥有清晰的判断位置和责任位置。
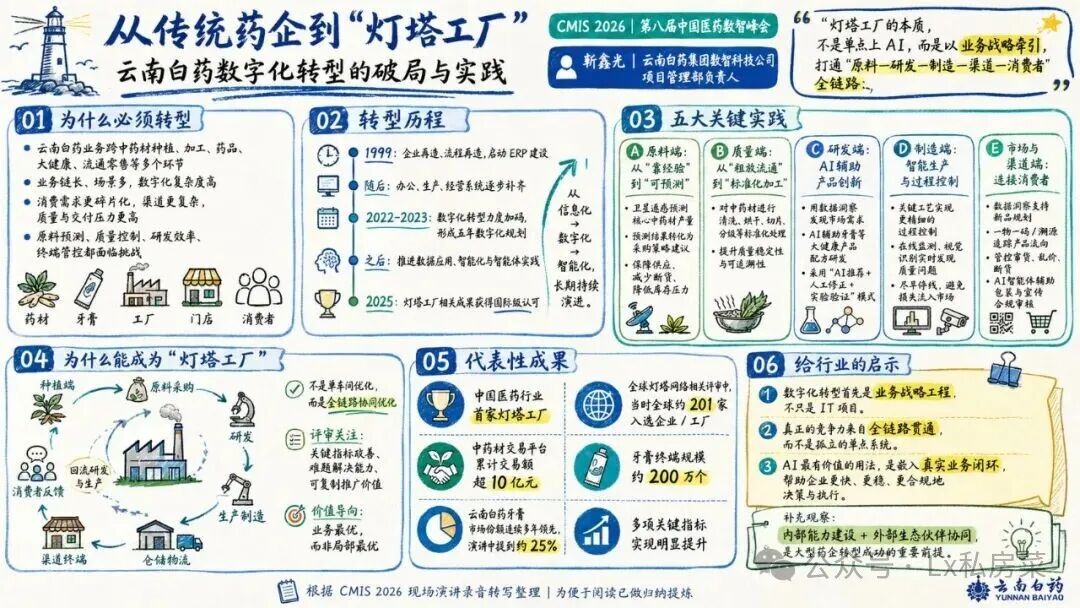
云南白药的分享让我看到另一种前置条件:从 ERP、流程再造、全链数字化,到数据和自动化,再走向 AI 与灯塔工厂。世界经济论坛和云南省国资委公开材料提供了这个案例的外部语境,但我更关心它给项目评审带来的提醒:如果企业还没有稳定的数据、流程和指标,直接谈 Agent,往往是在跳过最费时间的准备工作。
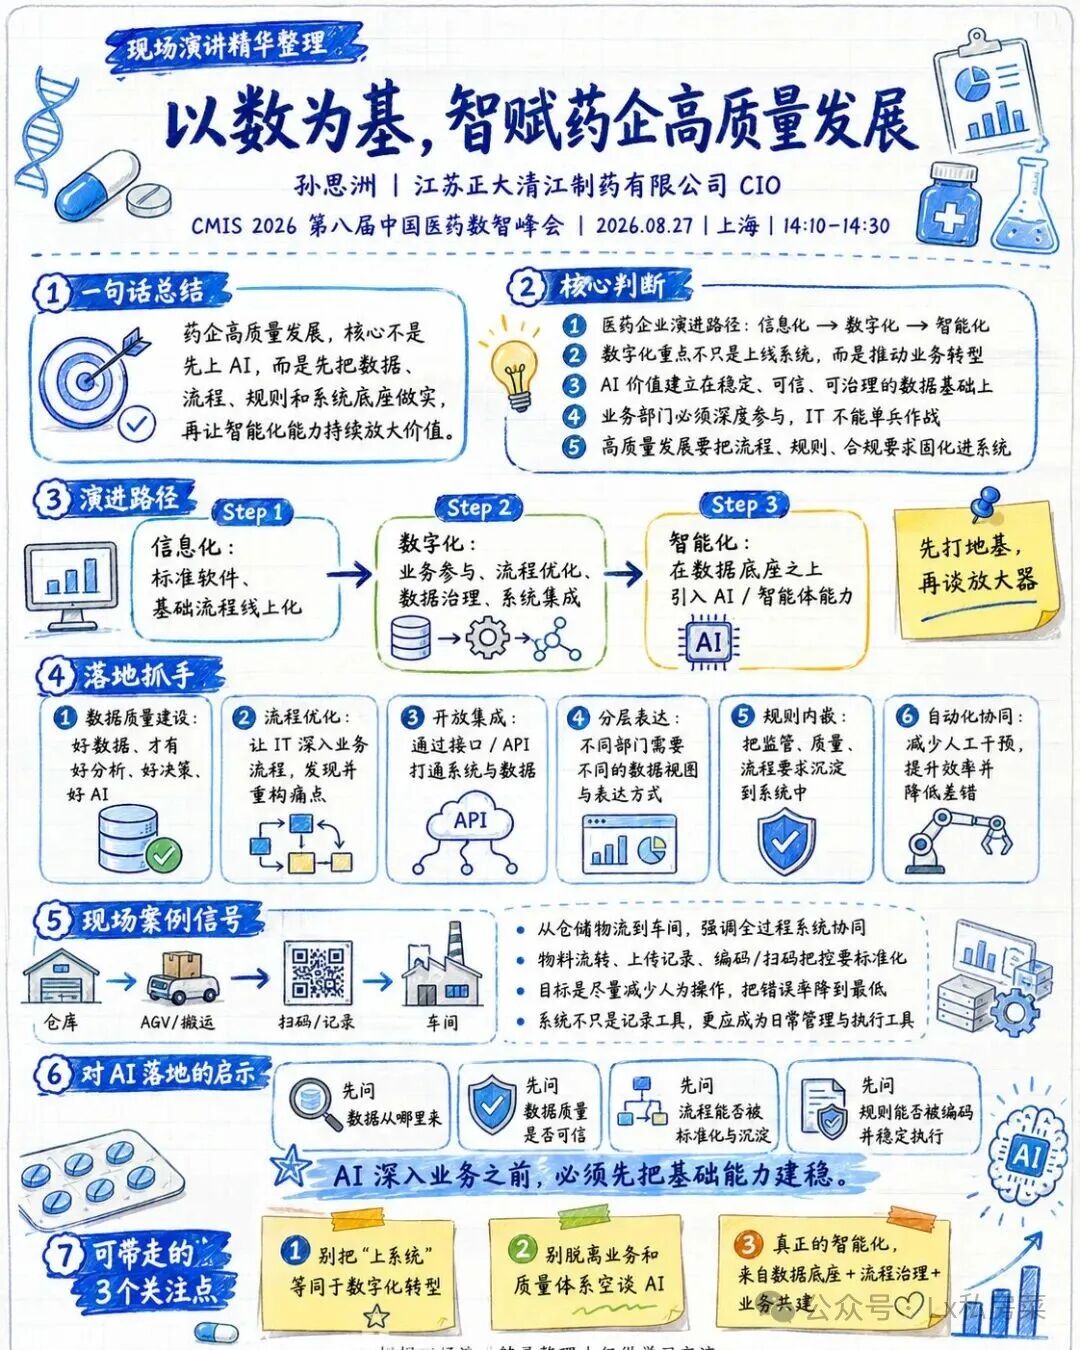
江苏正大清江制药的分享把这件事说得更直接:数字化不是 IT 部门的独角戏,业务必须参与流程和规则的定义。
我越来越相信,医药企业的 AI 护城河不是“生成能力”,而是可信执行能力。模型可以更换,工具也会更新,但一套能被业务、质量和监管共同检查的责任结构,才会沉淀下来。
我会用五个问题,判断一个项目是不是真进了生产
今天听完这些分享,如果让我明天去评审一个药企 AI 项目,我不会先问“用的是哪一个模型”,而会先问:
01它到底改变了哪一个真实流程?如果关掉它,业务结果会怎样变化?
02它拿到了什么上下文?这些文档、数据和规则有 Owner、有版本、有来源吗?
03它拥有哪些执行权限?哪些动作只能建议,哪些动作可以自动执行,异常时交给谁?
04一次错误能不能被发现、限制、追溯和恢复?质量、合规和 IT 是否能看到同一条审计链?
05项目用什么业务指标和成本指标证明值得继续维护?Token、人工复核、接口维护和模型变更的成本算进去了吗?
这五个问题背后,其实是一个判断:AI 是否已经从“功能”变成“组织能力”。FDE 之所以在今天的议程里出现得越来越频繁,也正是因为通用能力只有贴到业务现场,才能变成可运行的系统。但这并不意味着每家公司都要立刻建立一支 Agent 军团;更现实的路径,是先找到一条结果清晰、责任边界清楚的流程,做出可验证的闭环,再决定哪些能力值得复制。
今天我带走的最简短结论是:模型让 AI 有能力,企业上下文让它理解工作,权限和流程让它能够行动,证据和 Owner 才让它配得上“生产”。